 MIS CURSOS
GenerativeAIHub, IAGenerativa
RAG y grounding en SAP: cómo llevar conocimiento empresarial al modelo sin inventar respuestas
Un equipo de compras pregunta: «¿qué debemos hacer si el proveedor cambia la fecha de entrega de un pedido crítico?». El modelo puede redactar una respuesta convincente aunque no conozca vuestro procedimiento, la versión vigente de la política ni el responsable de aprobar una excepción. El riesgo no es solo que se equivoque: es que responda con seguridad y acelere una decisión tomada sobre una norma ya caducada.
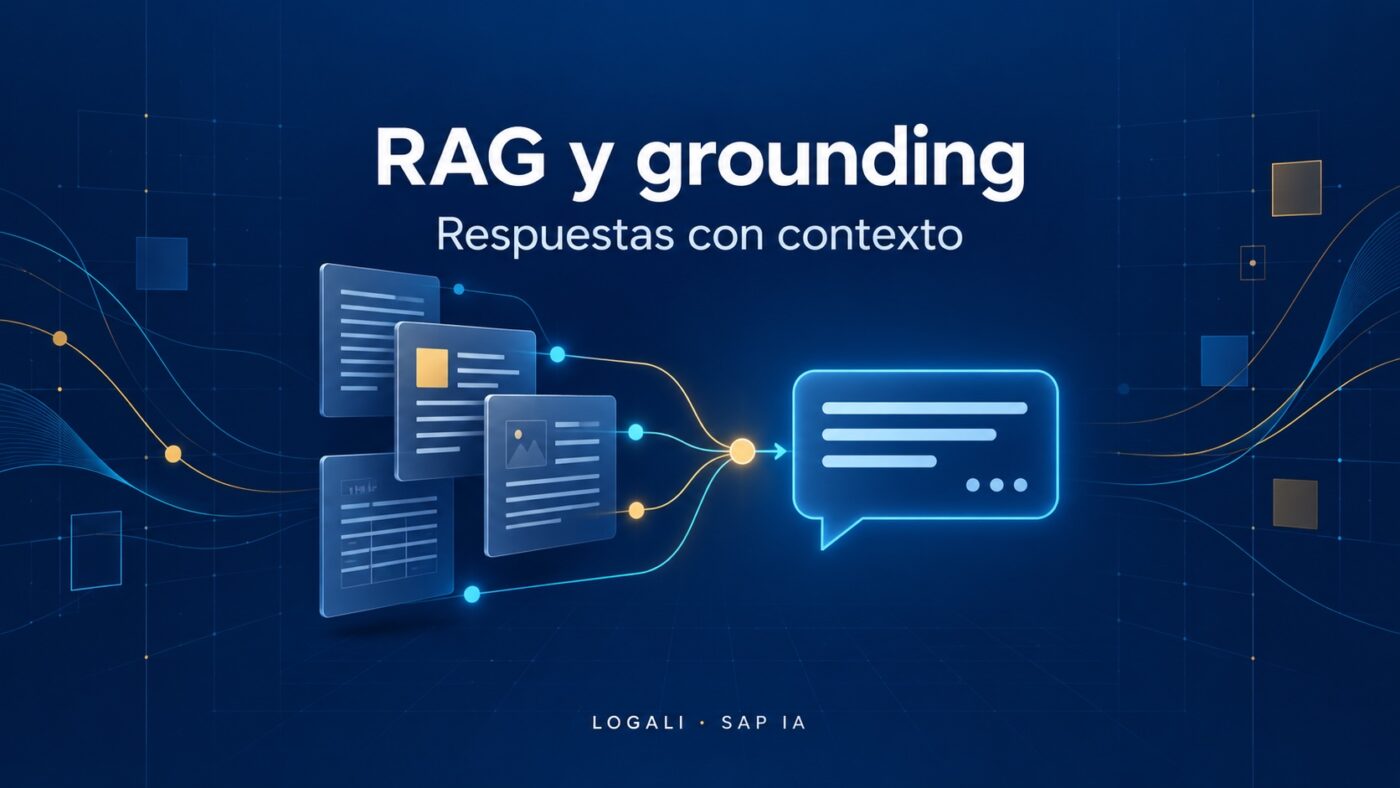
Ahí es donde entra RAG, siglas de Retrieval-Augmented Generation. En lugar de pedir al modelo que responda únicamente con lo que aprendió durante su entrenamiento, una aplicación busca primero evidencia en fuentes autorizadas y añade los fragmentos recuperados al contexto de la consulta. El modelo redacta después una respuesta a partir de esa evidencia y de las instrucciones que le damos.
En SAP, el término grounding se usa para integrar información externa, de dominio o en tiempo real que complemente el conocimiento general del modelo. En generative AI hub, el módulo es opcional y contempla tareas de recuperación con bases de datos vectoriales. La documentación de SAP sobre grounding describe ese papel con precisión: aporta contexto relevante; no transforma el modelo en una fuente infalible.
RAG no equivale a reentrenar un modelo, no garantiza que la respuesta sea correcta y no concede permisos sobre documentos.
Contenido
La cadena completa: de la pregunta a una respuesta con evidencia
Un RAG útil no empieza por elegir un modelo. Empieza por responder qué fuente contiene la decisión que el usuario necesita y quién puede leerla. A partir de ahí, la secuencia suele tener seis pasos:
- Seleccionar documentos vigentes y con propietario: por ejemplo, la política de tolerancias de factura, el procedimiento de altas de proveedor y una guía operativa de recepción de mercancía.
- Extraer texto y metadatos: título, versión, fecha de vigencia, proceso, sociedad, idioma, nivel de confidencialidad y enlace canónico al documento.
- Dividir el contenido en fragmentos que conserven sentido. Cada fragmento recibe un embedding, una representación numérica de su significado.
- Convertir la pregunta en una representación comparable y recuperar los fragmentos más relevantes, aplicando filtros de metadatos y de alcance.
- Enviar al modelo una instrucción clara, la pregunta y solamente los fragmentos recuperados.
- Validar la salida: comprobar que responde a la pregunta, que usa evidencia admisible y que se abstiene cuando la evidencia no alcanza.
Los embeddings no son una respuesta ni una clasificación de permisos. Son representaciones multidimensionales de texto que permiten hacer búsquedas semánticas: encontrar un fragmento que habla de «fecha confirmada» cuando la consulta dice «día de entrega acordado». SAP ofrece un endpoint de embeddings armonizado entre modelos en la versión V2 de Orchestration. SAP explica qué son y cómo se consumen los embeddings.
El diseño del fragmento decide más de lo que parece
Partir un PDF cada 1.000 caracteres puede ser rápido, pero suele cortar una excepción de la regla que la explica o separar una tabla de sus encabezados. La búsqueda entonces recupera una frase aparentemente relevante y el modelo completa lo que falta. El problema no está en el prompt; está en que la evidencia llegó rota.
Un fragmento razonable respeta primero la estructura del documento: sección, subtítulo, tabla y párrafo relacionado. Una política puede fragmentarse por regla y excepción; un manual de transacción, por tarea completa; una tabla de aprobaciones, por fila más los encabezados.
En cada fragmento conviene conservar metadatos para limitar la búsqueda: process: procurement, companyCode: 1000, documentStatus: approved, validFrom: 2026-01-01 o sourceUrl.
SAP permite buscar fragmentos relevantes en una colección concreta o en varias y filtrarlos por metadatos de colección, documento y fragmento. La API también permite limitar el número de fragmentos o documentos devueltos. La referencia de Vector Search detalla esos filtros y devuelve puntuaciones de recuperación. Úsalas para diagnosticar resultados, no como una medida universal de verdad: una similitud alta solo indica cercanía en ese espacio vectorial.
Permisos: filtrar después no convierte una fuente en autorizada
Una arquitectura de RAG debe hacer cumplir el permiso antes de recuperar o inyectar contenido. Si una persona no puede abrir un procedimiento de negociación, su asistente tampoco debe recibir un fragmento de ese procedimiento por el mero hecho de que el texto coincida con su pregunta.
Esto exige decidir dónde se resuelve la autorización. Puede ser en el sistema fuente, en el servicio que crea las colecciones, en los metadatos que se aplican a la consulta o en una combinación de controles. La decisión depende de los repositorios, la identidad del usuario y el modelo de acceso de la organización. Lo importante es que el filtro de companyCode o documentStatus no sustituye un control de acceso: son criterios de recuperación, no una política de identidad por sí mismos.
SAP documenta que el grounding puede conectar repositorios mediante secretos genéricos y enumera, entre otros, SharePoint, SAP Document Management service, SAP Build Work Zone, ServiceNow, Google Drive, S3 y SFTP. La lista de repositorios y su conexión ayuda a plantear una pregunta previa: ¿la cuenta técnica solo lee el conjunto que se permite indexar y cómo se revoca ese acceso?
También conviene revisar el alcance de las API. Un servicio de recuperación necesita credenciales, grupo de recursos y autorización para el entorno de AI Core; eso no autoriza automáticamente operaciones de negocio en S/4HANA. Mantén las credenciales de lectura y las de escritura separadas, con permisos mínimos, y registra qué identidad consultó qué fuente. Es diseño técnico y operativo, no una declaración de cumplimiento normativo.
Actualización, citas y respuestas que saben parar
Un índice es una copia de trabajo, no el documento maestro. Cuando se actualiza una política de compras, hay que identificar qué fragmentos proceden de la versión anterior, reindexar la nueva y evitar que ambas compitan sin una regla de vigencia. La fecha de indexación por sí sola no dice cuál es la política aprobada; usa versión, estado y fecha de efecto del documento.
Una buena respuesta RAG muestra de dónde procede cada afirmación importante. No hace falta revelar el contenido completo ni enlaces a los que la persona no tenga acceso. Sí debe presentar referencias útiles: nombre del documento, sección, versión y enlace canónico cuando la autorización lo permita. Eso permite pasar de «el asistente dice» a «reviso la fuente que el asistente usó».
Incluye en la instrucción de generación tres reglas sencillas: responder solo con los fragmentos suministrados; citar los fragmentos utilizados; y declarar que no hay evidencia suficiente si no se recupera una fuente pertinente. Después verifica programáticamente que toda cita corresponde a un fragmento entregado en esa petición. Una cita inventada no es trazabilidad.
Una pregunta sin fuente debe poder terminar en abstención. Por ejemplo: «¿qué importe máximo acepta el proveedor SUP-2048 sin aprobación adicional?». Si los fragmentos solo hablan de una política general y no contienen la matriz aplicable, el resultado correcto es dirigir al procedimiento o a la persona responsable, no inferir una cifra.
Lo que RAG no hace por ti
Un modelo de lenguaje no navega por la web, SharePoint o SAP por iniciativa propia. Solo recibe lo que la aplicación le pasa: la pregunta, las instrucciones y, si existe, el contexto recuperado. Si se quiere consultar una fuente, la arquitectura debe configurar ese conector, su identidad, sus límites y su actualización. Suponer que el modelo «ya buscará» crea respuestas que parecen documentadas sin estarlo.
Tampoco hay una obligación conceptual de usar SAP HANA para cada arquitectura RAG. SAP describe el grounding con almacenes vectoriales «como la base de datos HANA gestionada» y también permite aportar fragmentos por su Vector API sin registrar un repositorio. La creación del grupo de recursos para grounding explica ambos puntos. La elección de almacenamiento depende de las fuentes existentes, los requisitos de operación, residencia de datos, coste, capacidades de búsqueda y controles de acceso.
Un piloto de compras que se pueda evaluar
Antes de conectar miles de documentos, delimita un caso comprobable: responder preguntas internas sobre cambios de pedido y recepción de mercancía para un único proceso y sociedad. Prepara un conjunto de, por ejemplo, 30 preguntas de personas de compras, incluyendo preguntas con respuesta, preguntas ambiguas y preguntas que deben rechazar por falta de evidencia. Para cada una, registra la fuente esperada, el permiso requerido, la respuesta admisible y si puede mostrarse una cita.
El ejercicio propuesto no presupone que ya exista un flujo ni que se haya ejecutado en un sistema: define el conjunto, separa documentos vigentes de históricos, prueba la recuperación por sí sola y solo después prueba la generación. Revisa falsos positivos de recuperación, respuestas sin soporte, citas incorrectas y casos en que el asistente debería haber dicho «no lo sé». Con esa evidencia, el equipo puede decidir si ampliar fuentes, revisar fragmentos o mantener el caso como consulta asistida.
RAG aporta valor cuando reduce el tiempo de localizar una fuente fiable sin ocultar sus límites. El objetivo no es que el modelo parezca experto en la empresa. Es que la persona llegue antes a la evidencia correcta y conserve el criterio para actuar.
