 MIS CURSOS
IA, ABAP, IAGenerativa
SAP-ABAP-1 frente a Claude y GPT
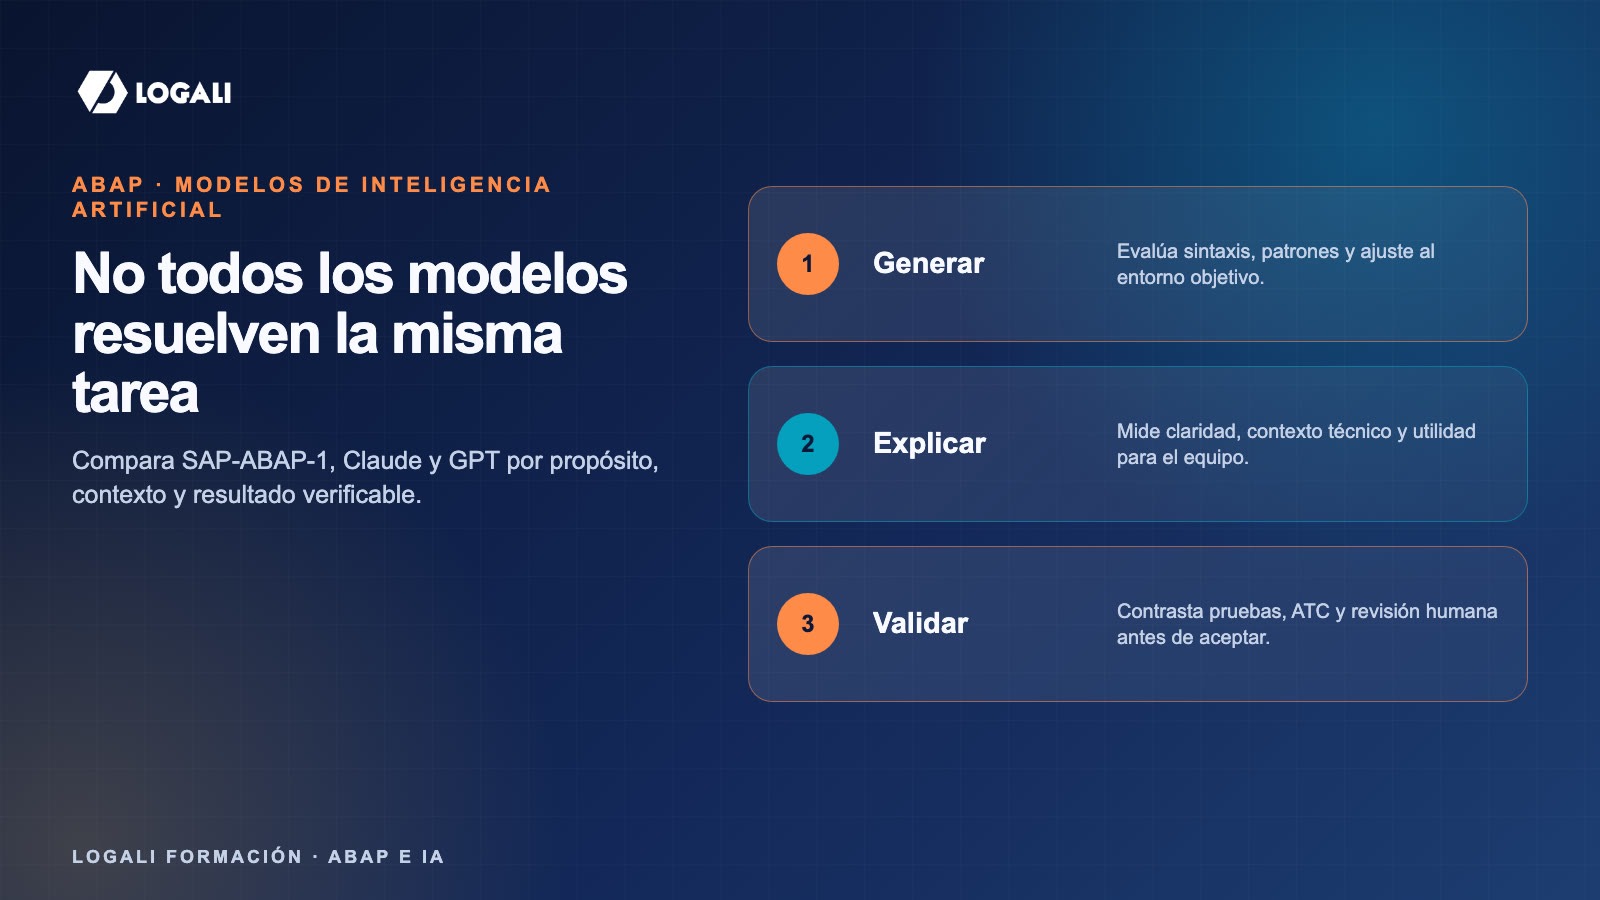
Comparar SAP-ABAP-1 con modelos generalistas puede aportar una lección útil: el nombre del proveedor no basta para decidir qué modelo emplear en una tarea ABAP. La comparación debe fijar tarea, entorno, versión, evaluación y coste. Un benchmark publicado permite iniciar esa conversación; no sustituye las pruebas del landscape propio.
Contenido
Qué se está comparando
SAP-ABAP-1 está disponible a través de Generative AI Hub en SAP AI Core. La documentación de SAP lo orienta principalmente a explicar código ABAP; la generación de código figura como experimental. Claude y GPT son modelos generalistas que pueden emplearse en tareas de código según la oferta y los controles disponibles. Las capacidades y versiones cambian, de modo que todo resultado debe llevar fecha y modelo exacto.
El benchmark de TH Köln
El preprint Benchmarking Large Language Models for ABAP Code Generation de TH Köln describe un benchmark de 180 tareas: 164 adaptadas de HumanEval y 16 escenarios ABAP de operación de base de datos. El código se crea, activa y prueba en un entorno ABAP Cloud Developer Trial; el éxito se mide por pruebas ABAP Unit, no por apariencia del resultado.
Cada tarea se ejecutó diez veces. Si el código no activa o no pasa las pruebas, el modelo recibe el error y puede corregirlo hasta cinco rondas. El estudio usa un prompt de sistema común y documenta su entorno, parámetros y dataset. La extensión de Marian Zeis reutiliza el benchmark para añadir Claude Opus 4.5, GPT-5.2 y SAP-ABAP-1; por eso los resultados de esa extensión deben leerse como una ejecución posterior, no como parte de la muestra original de 2025.
Resultados publicados por Zeis, consultados el 1 de octubre de 2026
| Modelo | Ronda 0 | Ronda 5 |
|---|---|---|
| Claude Opus 4.5 | 31,61 % | 78,72 % |
| GPT-5 | 19,28 % | 77,11 % |
| GPT-5.2 | 16,33 % | 64,00 % |
| SAP-ABAP-1 | 10,67 % | 19,89 % |
En esa configuración, Claude Opus 4.5 y GPT-5 obtuvieron una tasa acumulada superior tras recibir feedback de compilación y pruebas. SAP-ABAP-1 quedó por detrás en generación. Este dato no prueba que un modelo sea mejor para todas las tareas ABAP: las tareas no abarcan todo el desarrollo empresarial, y el resultado depende del prompt, la versión, el contexto y las herramientas disponibles.
Coste: un dato del experimento, no una tarifa
Zeis publica aproximadamente 20,26 USD para GPT-5.2, 39,76 USD para Claude Opus 4.5 y 98,80 EUR para SAP-ABAP-1 en sus ejecuciones. La comparación tiene un límite explícito: OpenAI y Anthropic usaron sus Batch API, mientras que ABAP-1 no disponía de esa opción. El coste también aumenta cuando un modelo requiere más rondas. Son observaciones útiles para reproducir la prueba, no precios de producto ni una previsión directa de producción.
Cómo usar el resultado en un equipo ABAP
El benchmark sugiere una hipótesis para probar: un modelo generalista fuerte, acompañado de contexto y feedback verificable, puede rendir bien en generación de clases ABAP. La hipótesis debe validarse con una evaluación propia. Selecciona tareas representativas, datos permitidos y criterios claros: activación, ATC, ABAP Unit, uso de APIs liberadas, revisión de código, latencia y coste contractual.
SAP-ABAP-1 puede evaluarse para explicación y mantenimiento de código, que es su orientación documentada. Las versiones incluidas en el experimento no constituyen una recomendación actual de compra. La decisión depende de la tarea, el modelo habilitado, el contexto permitido y las obligaciones de seguridad del cliente.
Controles que siguen siendo necesarios
- No enviar datos personales o confidenciales sin base de tratamiento y controles.
- Aplicar mínimo privilegio a herramientas y servidores MCP.
- Revisar cambios con ATC, pruebas unitarias y revisión humana.
- Registrar versión de modelo, prompt, herramientas, resultado y aprobación del transporte.
Fuentes y reproducibilidad
- TH Köln: Benchmarking Large Language Models for ABAP Code Generation
- Marian Zeis: extensión del benchmark y resultados
- SAP Help: SAP-ABAP-1
